Поиск больше не ограничивается списком ссылок. Google формирует AI Overviews и ответы в AI Mode, ChatGPT ищет информацию в интернете, а Microsoft Copilot использует материалы из Bing. Пользователь может получить готовое объяснение, сравнение или подборку, не открывая каждый найденный сайт по отдельности.
Из-за этого появились новые названия: AEO, GEO, LLM SEO, AI Search Optimization. Каждое описывает часть работы, но ни одно не отменяет обычное SEO. Чтобы попасть в ответ ИИ, страницу всё равно нужно обнаружить, обработать и правильно понять. При этом одного присутствия в поисковом индексе уже недостаточно: системе нужно выделить конкретный фрагмент, сопоставить его с вопросом и решить, стоит ли использовать его в ответе.
SEO для ИИ-поиска начинается с нормального сайта. Дальше добавляются более ясная подача информации, подтверждение утверждений, работа с внешними источниками и отдельное отслеживание упоминаний в генеративных ответах.
SEO, AEO, GEO и LLM SEO: в чём разница
Термины частично пересекаются, поэтому их часто используют как взаимозаменяемые.
| Подход | Главная задача | Где проявляется |
|---|---|---|
| SEO | Сделать страницы доступными, понятными и релевантными запросу | Обычная поисковая выдача и её новые форматы |
| AEO | Помочь системе извлечь точный ответ на вопрос | Краткие ответы, сниппеты и диалоговый поиск |
| GEO | Повысить вероятность использования материала как источника | Генеративные ответы, упоминания и цитирования |
| LLM SEO | Объединить работу с видимостью в системах на основе языковых моделей | Поисковые и диалоговые ИИ-интерфейсы |
SEO отвечает за видимость сайта в поисковых системах. Сюда входят техническое состояние, индексация, структура, содержание страниц, внутренние ссылки и внешние сигналы.
AEO расшифровывается как Answer Engine Optimization. Это работа над тем, чтобы поисковая или диалоговая система могла извлечь из страницы понятный ответ на конкретный вопрос. Такой подход существовал задолго до ChatGPT: краткие ответы, featured snippets и блоки People Also Ask решали похожую задачу.
GEO, или Generative Engine Optimization, относится к генеративным ответам. Задача состоит в том, чтобы материалы сайта использовались как источник, упоминались или цитировались в сформированном ответе.
LLM SEO обычно называют весь комплекс работ, связанный с видимостью в системах на основе больших языковых моделей. Это наиболее широкая, но пока наименее устоявшаяся формулировка.
На практике разделять эти направления жёсткой границей неудобно. Хорошая страница может одновременно ранжироваться в обычной выдаче, давать короткий ответ, использоваться в AI Overview и цитироваться в ChatGPT. Работа над ней во всех четырёх случаях во многом будет одинаковой.
Как ИИ-поиск находит информацию
У разных систем свои механизмы, но общая последовательность выглядит знакомо:
- Система обнаруживает страницу.
- Получает доступ к её содержанию.
- Обрабатывает текст и другие доступные данные.
- Сопоставляет материал с запросом пользователя.
- Выбирает фрагменты и источники для ответа.
- Формирует ответ и, если интерфейс это предусматривает, показывает ссылки.
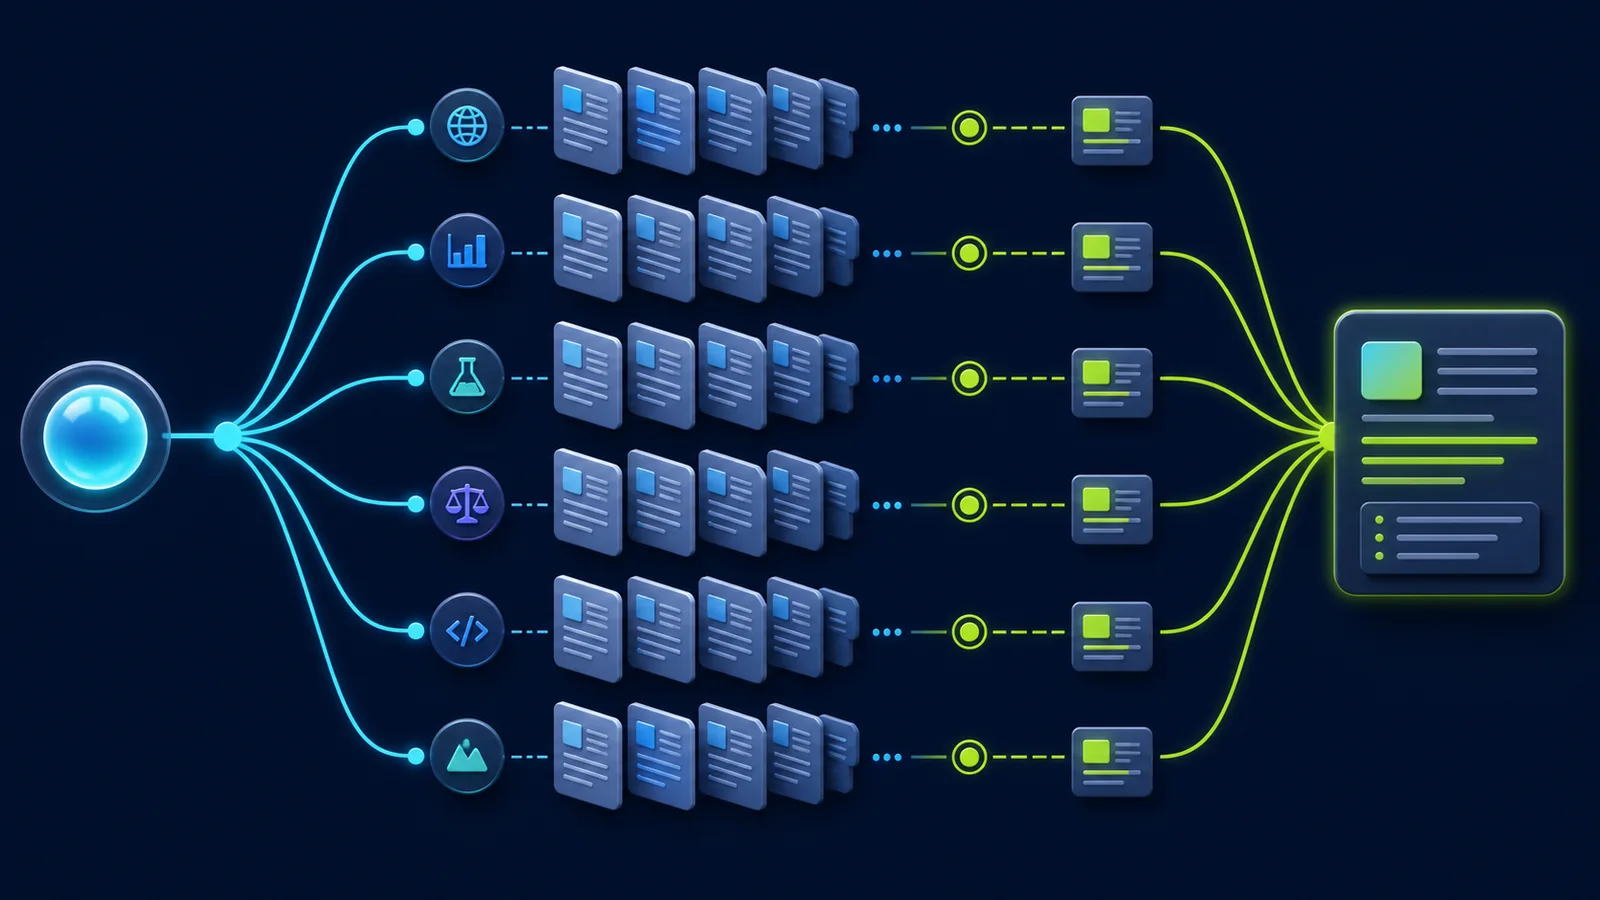
В Google AI Overviews и AI Mode страницы должны соответствовать обычным техническим требованиям поиска. Google прямо указывает, что отдельной специальной оптимизации для этих форматов не требуется. Страница должна индексироваться и иметь право показываться в поиске со сниппетом. также описывает query fan-out: система может выполнить несколько связанных поисков по разным подтемам, прежде чем собрать ответ.
Это меняет представление о запросе. Пользователь задаёт один сложный вопрос, но система разбивает его на несколько более узких. В результате источником может стать не только страница, оптимизированная под исходную формулировку, но и материал, хорошо отвечающий на одну из дополнительных частей вопроса.
У ChatGPT есть отдельный поисковый робот OAI-SearchBot. OpenAI рекомендует не блокировать его, если владелец хочет, чтобы содержимое сайта могло попадать в поисковые ответы и сопровождаться ссылкой. При этом OAI-SearchBot и GPTBot выполняют разные функции: первый связан с поиском, второй — с возможным использованием материалов для обучения моделей. Ограничивать их можно независимо. Это описано в .
Что в SEO осталось прежним
Страница должна быть доступна для обхода
Если поискового робота блокирует robots.txt, защита CDN, сервер или обязательное выполнение сложного клиентского JavaScript, содержимое может остаться недоступным. ИИ не исправляет технические проблемы сайта и не угадывает то, чего не получил.
Нужно проверять статус ответа, канонические адреса, директивы индексации, работу мобильной версии и доступность основного текста в HTML. Эти требования одинаково важны для обычной и генеративной выдачи.
Каждая страница должна решать понятную задачу
Страница, которая поверхностно затрагивает десять разных тем, обычно слабее страницы с ясным назначением. Название, заголовок, основной текст и связанные материалы должны объяснять, какой вопрос здесь закрывается.
Это не означает, что нужно создавать отдельный URL под каждую формулировку. Несколько близких вопросов можно объединить, если пользователь ожидает увидеть ответы на них в одном месте. Разные намерения лучше разводить по отдельным страницам.
Структура сайта по-прежнему имеет значение
Внутренние ссылки помогают находить материалы и понимать отношения между ними. Страница услуги может ссылаться на подходящий кейс, статью, определение термина и смежную услугу. Так отдельные публикации складываются в связанную систему, а не остаются изолированными документами.
Нормальная иерархия заголовков также остаётся важной. Она организует содержимое для людей, поисковых систем, экранных дикторов и упрощённых режимов просмотра. Заголовки должны отражать структуру материала, а не использоваться только ради размера шрифта.
Полезность нельзя заменить количеством текста
Длинная статья не становится хорошей автоматически. Объём нужен там, где без него нельзя полноценно ответить на вопрос.
Слабый материал можно растянуть на несколько тысяч слов, повторяя одну мысль разными формулировками. Для поиска и читателя полезнее конкретные объяснения, примеры, ограничения, таблицы и данные, которые действительно помогают принять решение.
Что изменилось с появлением ИИ-поиска
Запросы стали длиннее и сложнее
В обычном поиске человек часто вводит короткую фразу, открывает несколько страниц и уточняет запрос. В диалоговом интерфейсе он может сразу описать ситуацию, ограничения и желаемый результат.
Поэтому контенту недостаточно несколько раз повторить основную ключевую фразу. Страница должна закрывать связанные вопросы: кому подходит решение, как оно работает, какие есть варианты, от чего зависит стоимость, какие ограничения нужно учитывать и что делать дальше.
Это не требование написать на каждой странице энциклопедию. Нужна достаточная полнота именно по выбранной задаче.
Важнее стала возможность извлечь конкретный ответ
Полезная информация не должна прятаться внутри длинного вступления. Если раздел отвечает на вопрос, ответ лучше дать в первых предложениях, а затем объяснить детали.
Таблицы подходят для сравнения. Последовательность действий удобнее оформлять этапами. Короткий перечень требований лучше воспринимается списком. Обычный связный текст нужен там, где мысль нельзя честно свести к нескольким пунктам.
Не следует превращать каждую страницу в бесконечный FAQ. Формат выбирается по содержанию, а не ради предполагаемой любви алгоритмов к спискам.
Системам нужны понятные и непротиворечивые факты
Название компании, перечень услуг, адрес, регион работы, авторство материала и другие сведения не должны меняться от страницы к странице без причины.
Если сайт заявляет одно, профиль компании содержит другое, а сторонние каталоги показывают устаревшие данные, системе сложнее определить, какой версии доверять. Особенно заметна эта проблема у локальных компаний, интернет-магазинов и сервисов с большим количеством похожих страниц.
Собственный опыт стал ценнее пересказа
Генеративная система сама умеет собрать общее объяснение из нескольких источников. Ещё один пересказ известных рекомендаций редко добавляет что-то новое.
Больше пользы дают собственные примеры, фотографии, измерения, кейсы, сравнения, выводы из практики и точные условия работы. Такой материал сложнее заменить краткой компиляцией из чужих статей.
Важны не только текстовые страницы
Google отдельно обращает внимание на изображения, видео, данные о товарах и информацию в Business Profile. Поиск становится мультимодальным: пользователь может задать вопрос с изображением или искать объект по фотографии.
Изображение должно дополнять материал, а не занимать место ради оформления. Нужны понятные подписи, корректные альтернативные описания и контекст на самой странице. Для товара, работы или результата полезнее реальная иллюстрация, чем случайная фотография из фотобанка.
Упоминания за пределами собственного сайта
ИИ-поиск может собирать ответ из нескольких источников. Поэтому представление о компании формируется не только на её сайте.
Для бизнеса полезны:
- заполненные профили компании в подходящих сервисах;
- отраслевые каталоги и площадки;
- публикации и интервью;
- реальные отзывы;
- кейсы клиентов и партнёров;
- последовательное использование названия, сайта и контактных данных.
Размещаться можно и на небольших бесплатных площадках, если это не требует существенных затрат и не создаёт репутационных рисков. Не каждая такая ссылка даст измеримый результат, но дополнительное корректное упоминание компании может помочь поисковым системам сопоставить сведения из разных источников.
Платные публикации требуют более строгого отбора. Здесь уже важно оценивать аудиторию площадки, тематическую связь, качество материала и практический смысл размещения. Покупать упоминания на случайных сайтах только ради отчёта не стоит.
Наличие внешних публикаций не гарантирует попадание в генеративный ответ. Оно лишь расширяет набор источников, из которых система может получить сведения о компании или теме.
Экспериментальные меры: что можно попробовать без завышенных ожиданий
У ИИ-поиска пока нет единого стандарта оптимизации. Некоторые меры не подтверждены как фактор видимости, но стоят недорого и не мешают основной работе. Их можно тестировать, если сначала закрыты более важные задачи.
llms.txt
llms.txt — предложенный формат файла с кратким описанием сайта и ссылками на важные материалы. Его идея описана на . Формат развивается и используется рядом сайтов и платформ, но не является универсальным требованием поисковых систем.
Google прямо пишет, что для появления в AI Overviews и AI Mode дополнительные AI-файлы не нужны. Это не означает, что llms.txt бесполезен во всех возможных системах. Он может упростить доступ к структуре сайта для отдельных инструментов и агентов.
Если файл генерируется автоматически, содержит актуальные ссылки и почти не требует поддержки, его можно добавить. Ожидать роста позиций или цитирований только из-за его наличия не стоит.
Отдельные правила для поисковых роботов
Полезно проверить, какие роботы разрешены или запрещены в robots.txt. Особенно важно не путать поисковый доступ с обучением моделей.
Например, OAI-SearchBot отвечает за поиск ChatGPT, а GPTBot связан с возможным обучением. Владелец может разрешить один сценарий и запретить другой. Аналогичные правила нужно проверять по документации конкретной системы, а не копировать готовый файл с чужого сайта.
Машиночитаемые данные
Корректная разметка Schema.org помогает описать организацию, статью, товар, услугу, автора или навигацию. Она должна соответствовать тому, что человек видит на странице.
Специальной схемы для попадания в ИИ-ответы Google не требует. Добавлять несуществующие типы разметки или размечать скрытые сведения бессмысленно. Лучше использовать подходящие стандартные сущности и поддерживать их в актуальном состоянии.
Версии материалов в простом формате
Документации, справочники и базы знаний иногда дополнительно публикуют в Markdown или другом формате без сложного интерфейса. Это может облегчить обработку материалов отдельными инструментами.
Для обычного коммерческого сайта такая версия нужна не всегда. Если её легко получать из той же CMS и она не создаёт дубликаты в поисковом индексе, эксперимент возможен. Поддерживать вручную вторую копию всего сайта ради гипотетического эффекта обычно невыгодно.
Как подготовить сайт к ИИ-поиску
1. Проверить технический доступ
Сначала нужно убедиться, что важные страницы открываются с кодом 200, не запрещены для индексации и доступны нужным поисковым роботам. Заодно проверяются канонические URL, карта сайта, перенаправления и серверный рендеринг основного содержимого.
2. Определить, какие вопросы должен закрывать сайт
Для каждой услуги или направления нужно собрать не только короткие запросы, но и реальные вопросы потенциальных клиентов. Затем их распределяют между страницами так, чтобы разные URL не повторяли друг друга и не конкурировали за один смысл.
3. Сравнить содержание с сильными страницами в выдаче
Анализ конкурентов нужен не для копирования текста. Он показывает, какую информацию пользователь уже привык получать по запросу и какие вопросы другие сайты закрывают лучше.
Из нескольких конкурентов собирается общий набор смысловых блоков. После этого для своей страницы готовится структура, которая не пропускает полезные темы и при этом учитывает реальные особенности компании.
4. Переписать слабые страницы
Основной ответ лучше размещать ближе к началу. Дальше можно раскрыть условия, процесс, примеры, ограничения и связанные вопросы.
Заголовки должны помогать ориентироваться в материале. Таблицы, списки и FAQ добавляются только там, где они упрощают восприятие. Факты и числа нужно подтверждать или убирать.
5. Связать материалы между собой
Страницы услуг, статьи, кейсы и определения должны ссылаться друг на друга по смыслу. Это помогает пользователю продолжить изучение темы, а поисковой системе — обнаружить связанные материалы.
Анкор ссылки должен объяснять, куда она ведёт. Формулировки вроде «подробнее» или «читать здесь» полезны только тогда, когда смысл понятен из окружающего текста.
6. Привести в порядок внешнее присутствие
Нужно проверить профили компании, отраслевые площадки, каталоги и другие управляемые источники. Название, адрес, сайт и описание услуг должны совпадать с актуальными данными.
Затем можно планировать новые публикации, кейсы и упоминания на площадках, которые имеют отношение к деятельности компании.
7. Добавить недорогие эксперименты
После основной работы можно настроить доступ отдельных AI-роботов, добавить llms.txt, проверить разметку и протестировать упрощённые версии материалов.
Эти меры лучше вести отдельным списком. Тогда будет понятно, что относится к обязательной основе, а что проверяется как гипотеза.
8. Настроить измерение
До начала изменений нужно зафиксировать текущие показатели. Иначе через несколько месяцев будет сложно понять, что именно изменилось.
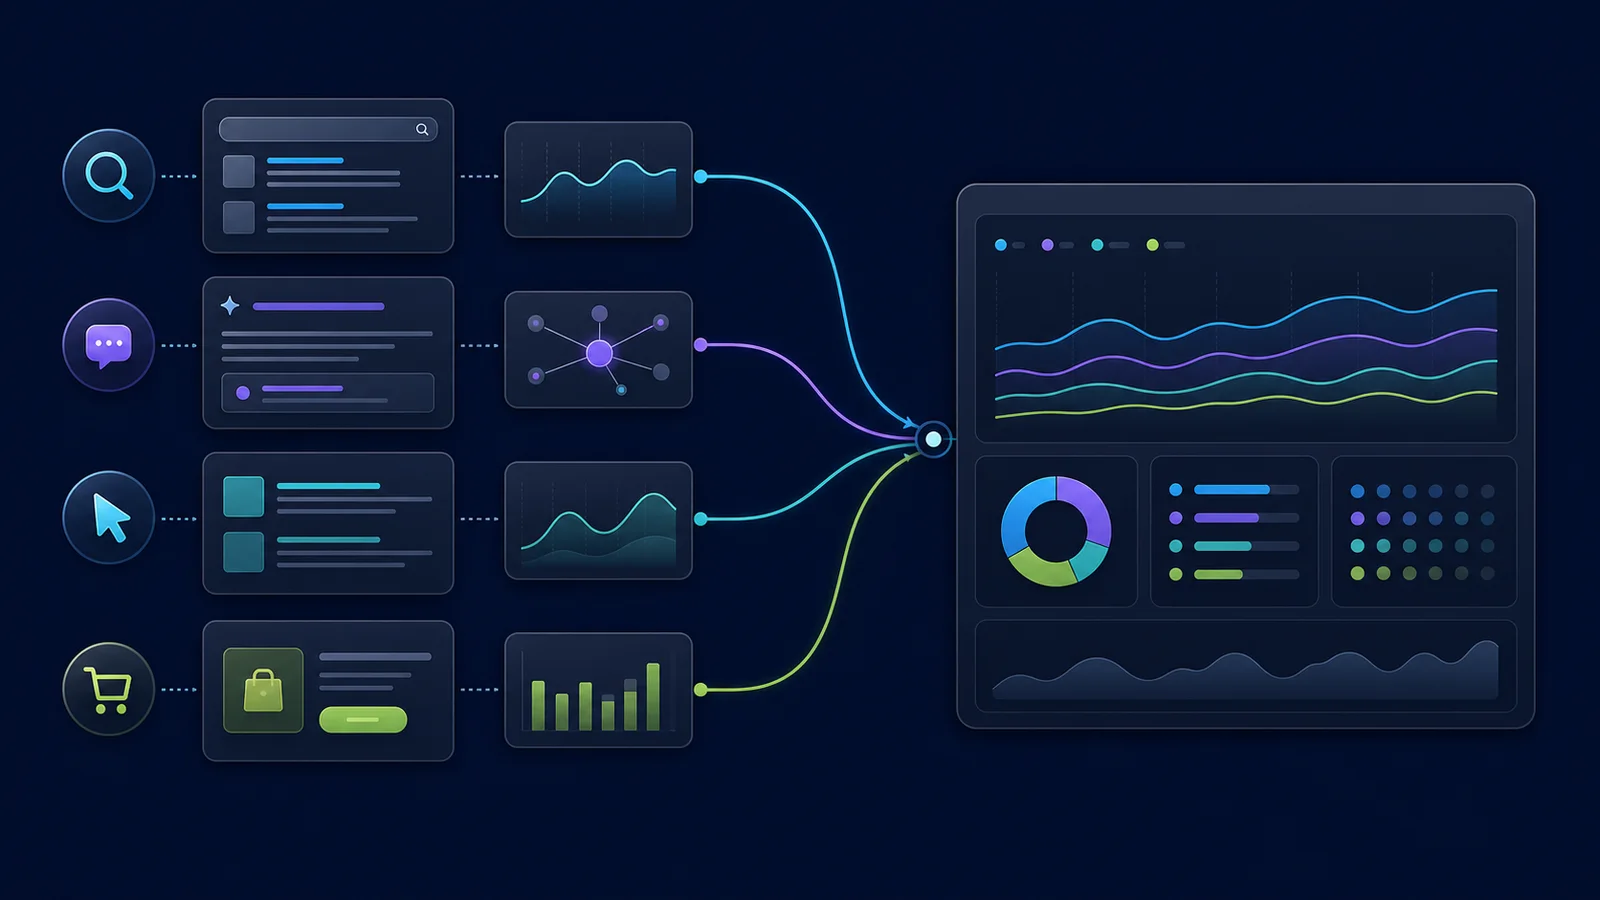
Отслеживать следует поисковую видимость, переходы, цитирования, брендовые запросы и целевые действия на сайте. Один показатель не даёт полной картины.
Как измерять видимость в ИИ-поиске
Измерение пока менее стандартизировано, чем в обычном SEO. Единого отчёта, который показывает все упоминания сайта во всех моделях, нет.
Google начал развивать отдельные отчёты по генеративным функциям в Search Console. Доступность таких отчётов может различаться между сайтами, поэтому общие данные обычного поиска также остаются важными.
В Bing Webmaster Tools появился отчёт AI Performance. Он показывает цитирования, страницы-источники и запросы, по которым содержимое использовалось в поддерживаемых продуктах Microsoft. Сам Microsoft уточняет, что количество цитирований не является позицией или оценкой авторитетности страницы. Подробнее это описано в .
OpenAI добавляет к переходам из поиска ChatGPT параметр utm_source=chatgpt.com. Такие визиты можно выделить в системе аналитики. Однако отсутствие перехода не означает отсутствие упоминания: пользователь может прочитать ответ и не открыть источник.
Дополнительно можно регулярно проверять заранее подготовленный набор вопросов в нескольких системах. Такой мониторинг показывает, какие источники используются и как описывается компания. Результаты нельзя воспринимать как постоянные позиции: ответы меняются в зависимости от формулировки, контекста, региона и текущей версии системы.
Полезный набор показателей:
- переходы из ChatGPT, Copilot и других определяемых источников;
- количество страниц, получающих такой трафик;
- цитирования и упоминания в доступных отчётах;
- видимость по постоянному набору проверочных вопросов;
- брендовые запросы;
- заявки и другие целевые действия после переходов.
Что делать дальше
ИИ-поиск не обнулил SEO. Он расширил количество интерфейсов, через которые человек получает найденную информацию.
Техническая доступность, структура сайта, соответствие запросу, полезный контент и внешние сигналы остались основой. Поверх них появилась новая задача: сделать информацию достаточно ясной, конкретной и подтверждённой, чтобы система могла безопасно использовать её в готовом ответе.
AEO и GEO удобно использовать как названия отдельных направлений работы. Но создавать для них полностью изолированную стратегию пока рано. Сайт должен одинаково хорошо работать для обычного поиска, генеративных ответов и людей, которые переходят на страницу за подробностями.
Эксперименты тоже нужны. Важно только не перепутать их с фундаментом и не обещать результат, который пока невозможно честно спрогнозировать.
Частые вопросы
Заменит ли GEO обычное SEO?
Нет. Генеративным системам всё равно нужно обнаружить, обработать и выбрать источник. Техническое SEO, структура сайта, полезный контент и внешние сигналы продолжают влиять на доступность и понимание материалов.
GEO добавляет внимание к цитируемости, ясности ответов и представлению компании в разных источниках.
Нужно ли создавать отдельные страницы специально для ChatGPT?
Не обязательно. Отдельная страница нужна, если она закрывает самостоятельный запрос или задачу пользователя.
Создавать второй вариант уже существующего материала только для ChatGPT обычно нет смысла. Лучше улучшить основную страницу и сделать её доступной для поисковых роботов.
Гарантирует ли llms.txt попадание в ответы ИИ?
Нет. llms.txt остаётся развивающимся предложением, а не подтверждённым фактором ранжирования или цитирования.
Добавить его можно как недорогой эксперимент, особенно если файл формируется автоматически. Основные ресурсы всё равно следует направлять на доступность сайта, содержание страниц и внешние источники.
Нужна ли специальная Schema.org-разметка для ИИ-поиска?
Специальной универсальной разметки для ИИ-ответов нет. Google не требует отдельную AI-схему для AI Overviews или AI Mode.
Нужно использовать существующие типы Schema.org там, где они подходят содержанию страницы, и следить, чтобы разметка совпадала с видимым текстом.
Нужно ли разрешать GPTBot?
Это зависит от отношения владельца сайта к использованию материалов для обучения. Для появления в поиске ChatGPT важнее доступ OAI-SearchBot.
OpenAI позволяет управлять этими роботами независимо. Перед изменением robots.txt стоит определить, какие сценарии владелец хочет разрешить.
Можно ли гарантировать упоминание компании в ChatGPT или AI Overview?
Нет. Даже выполнение всех технических требований не гарантирует индексацию, показ страницы или её цитирование.
Можно повысить доступность и качество источника, но окончательный выбор делает конкретная система для конкретного запроса.
Через сколько появится результат?
Универсального срока нет. Он зависит от повторного обхода страниц, состояния сайта, конкуренции, частоты обновления индекса и самой системы.
Сначала нужно зафиксировать исходные показатели, а затем оценивать изменения по сопоставимым периодам. Отдельные тестовые вопросы не заменяют полноценную аналитику.
Как понять, что работа приносит пользу?
Нужно смотреть не только на переходы. Полезны данные о цитированиях, появлении новых страниц-источников, брендовых запросах, целевых действиях и видимости по постоянному набору вопросов.
Если система приводит меньше посетителей, но эти посетители чаще отправляют заявки, такой трафик может быть ценнее большого количества случайных переходов.